


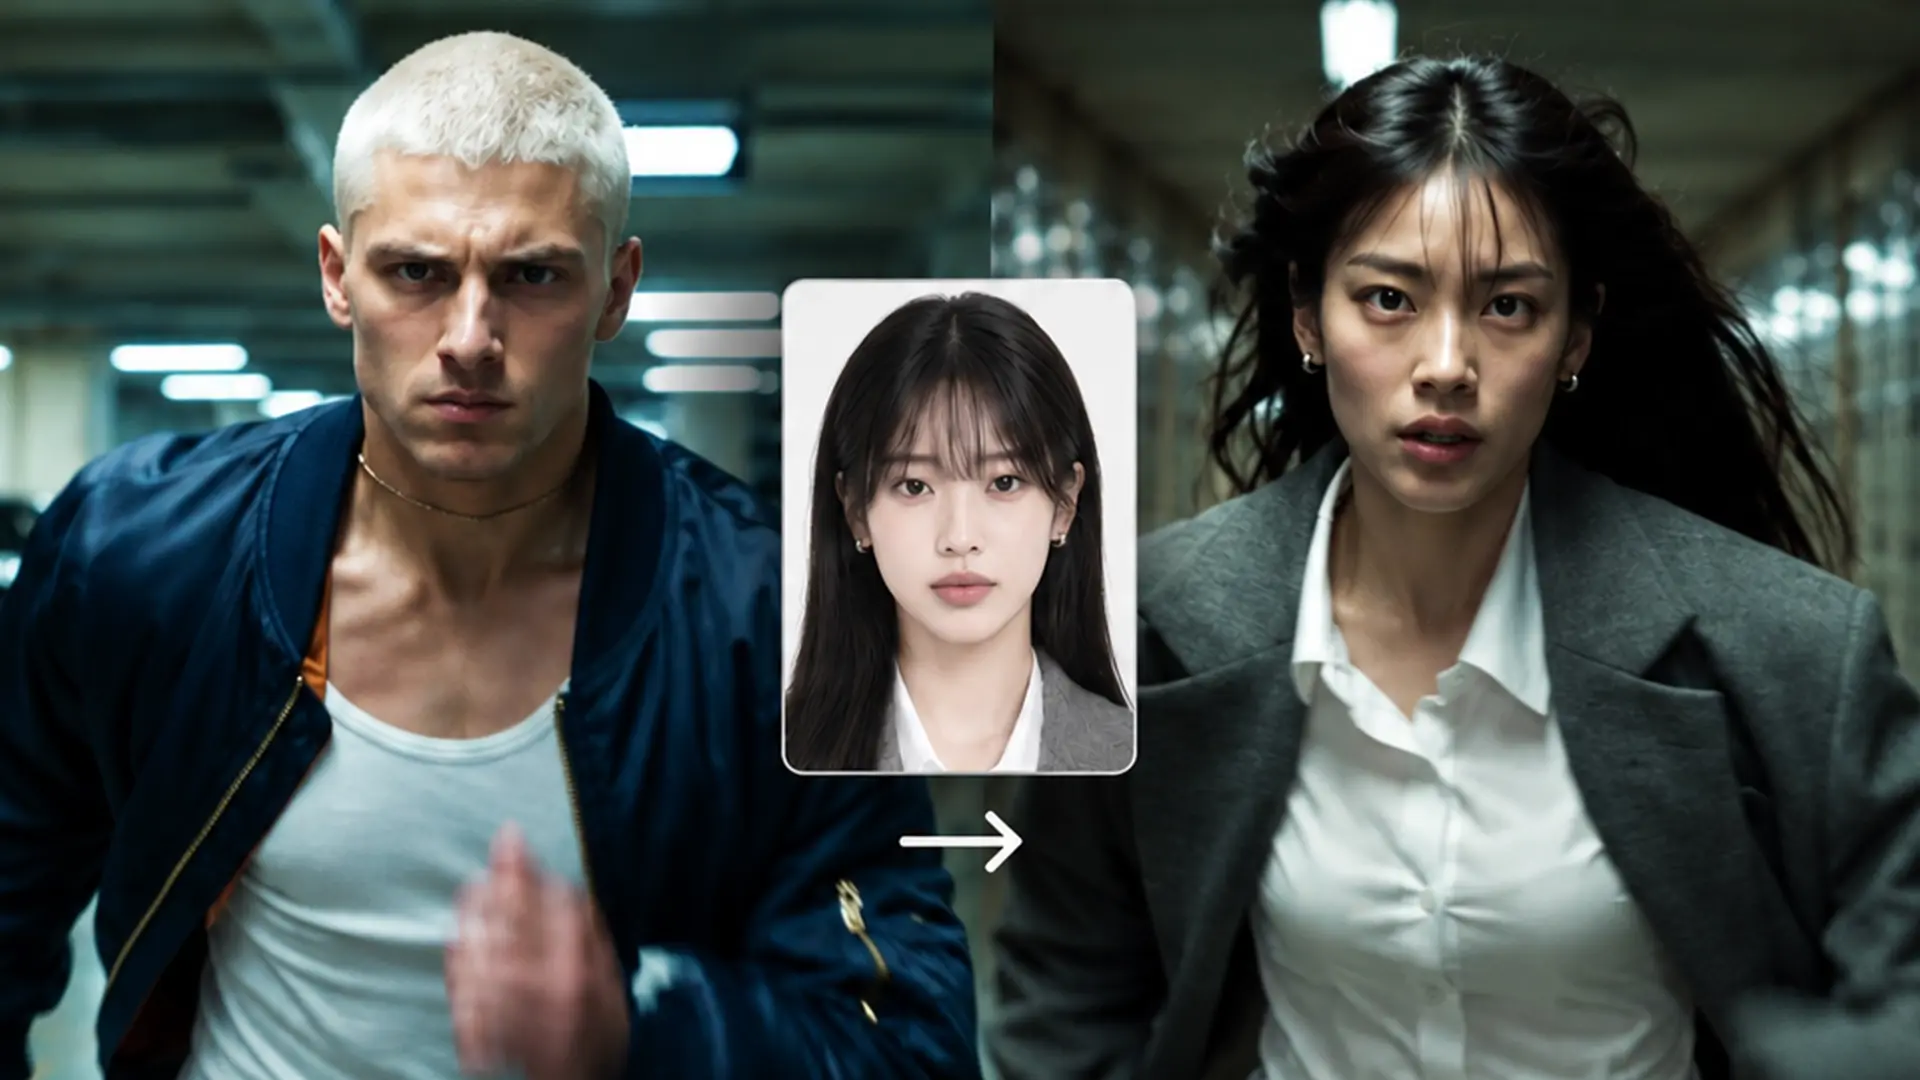
Kullanıcıların 600'ü aşkın yapay zeka modeline tek bir platformdan erişmesini sağlayan each::labs, kendi ekibiyle geliştirdiği yeni video modeli Lockstep'i tanıttı. Lockstep, "karakter değiştirme" alanına odaklanarak, tek bir fotoğrafla kaynak görüntüdeki kişilerin orijinal görüntüdeki hareketlere sadık kalarak değişmesini sağlıyor.
Orijinal çekimdeki hareketi, dudak senkronunu ve kamera kullanımını koruyan model, çalışırken referans bir videoya ve değiştirilecek her karakter için net bir fotoğrafa ihtiyaç duyuyor. Kullanıcılar fotoğrafları komut içinde @Image1, @Image2 gibi etiketlerle tanımlayıp hangi kişinin kiminle değiştirileceğini belirtiyor.
Şirketin açıklamasına göre Lockstep, yeni karakterleri orijinal çekimdeki adımlar, dönüşler ve jestlerle kare kare eşleştiriyor. Ağız hareketleri orijinal kaydı takip ettiği için şarkı ve diyalog sahnelerinde senkron korunuyor. Elde çekim titremesi, pan hareketleri ve hızlı kamera geçişleri de çıktıya olduğu gibi aktarılıyor. Video süresi ve zamanlaması değişmezken, komutta aksi belirtilmedikçe arka plan, ışık ve kadraj da çekildiği haliyle kalıyor.
Model; yüz, saç, ten rengi ve kıyafeti fotoğraftan alıp videonun başından sonuna kadar tutarlı biçimde koruyor. Tek bir kişinin yanı sıra bir grubun tamamı da tek seferde değiştirilebiliyor. Lockstep’in yalnızca insanlarla sınırlı olmadığı; evcil hayvanlar, maskotlar ve stilize karakterlerle de çalıştığı belirtildi.
480p, 720p veya 1080p olmak üzere çıktıda üç çözünürlük seçeneği sunuyor. Model Playground'da, API aracılığıyla veya mevcut iş akışının içinde kullanılabiliyor.
Kullanım bazlı fiyatlandırılan modelde her işlemin maliyeti çalıştırılmadan önce gösteriliyor. each::labs, tüm taleplerin işleme alınmadan önce içerik güvenliği kontrolünden geçtiğini ve kullanıcıların yalnızca kullanım hakkına sahip oldukları görüntü ve fotoğrafları yükleyebileceğini vurguladı.


Popüler İçerikler